Quel est l’impact environnemental de notre usage de l’IA générative ? Chez Nuageo, nous accompagnons des directions informatiques sur l’empreinte de leur numérique et nous utilisons Claude au quotidien. Voici comment nous avons tenté d’y répondre, entre septembre et octobre 2026.
Une question simple, posée à nous-mêmes
Notre point de départ : l’export de la console d’administration qui suit notre consommation de tokens (des morceaux de mots, environ trois quarts de mot chacun), pour six personnes, sur une soixantaine de jours ouvrés de l’été 2026. Il donne des volumes précis par personne et par modèle, mais rien sur l’énergie ni sur les serveurs.
Résultat : notre usage consommerait environ 382 kWh par an (112 kWh estimés sur trois mois, ramenés à une année), dans une fourchette de 220 à 2 700 kWh selon les hypothèses, soit un facteur 12. Aucun chiffre ne vient d’une mesure chez un éditeur : tout repose sur des estimations publiques appliquées à nos volumes réels. Nous disons à chaque étape ce qui est mesuré, ce qui est estimé et ce qui relève d’une hypothèse de notre part.
Deux constats tiennent pourtant dès le simple classement de l’export. L’usage est très hétérogène d’une personne et d’une tâche à l’autre. Et les modèles de la classe Opus, les plus gros du catalogue, concentrent 72 % de l’énergie estimée.
Compter par requête ne dit rien
En 2025, deux chiffres ont fait le tour de la presse : 0,24 Wh pour une requête texte médiane sur Gemini, publié par Google, et 0,34 Wh pour une requête ChatGPT moyenne, avancé par Sam Altman sans méthode jointe. Aucun des deux ne précise le nombre de tokens ni le modèle utilisé.
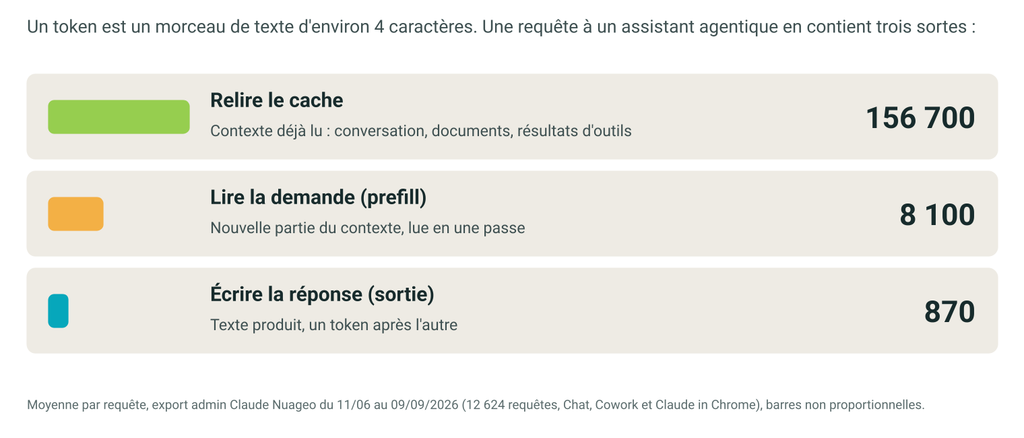
Or, chez nous, une requête moyenne génère 871 tokens et en lit 164 000. Une trace d’usage conversationnel publiée par Microsoft en 2024 (Splitwise) donne 129 tokens générés et moins de 8 tokens lus par token produit. Selon l’usage (simple chat ou session dite agentique, qui relit des documents) et le modèle, l’énergie d’une requête varie d’un facteur 100 d’après nos calculs.
Nous avons donc abandonné la requête comme unité. Nous retenons l’énergie pour 1 000 tokens générés, par modèle, avec le volume de contexte lu comme second paramètre. Sur notre usage : 10,2 Wh pour 1 000 tokens générés, dans une plage de 5,9 à 72 Wh. Ramené à 1 000 tokens, le 0,24 Wh de Google donne de l’ordre de 1 Wh, sur de petits modèles servis sur du matériel maison : dix fois moins que notre valeur centrale, dominée par Opus et par des contextes de 164 000 tokens.
Le modèle lit bien plus qu’il n’écrit
Dans notre export, pour chaque token écrit, le modèle en lit 189, dont 95 % depuis un cache (un contexte déjà traité à la requête précédente). EcoLogits, la bibliothèque ouverte qui nous sert de base, ne compte que les tokens générés. Pour nos usages, elle ignore la plus grande part du travail.
Lire un contexte coûte moins cher par token que le générer, mais combien de fois moins ? Les mesures publiées, sur de petits modèles ouverts, vont de 1/4 à 1/90. Nous avons retenu 1/21 en référence et 1/6 en valeur haute. Un token relu depuis le cache, lui, vaut environ 1/260 d’un token généré, d’après deux études récentes (CLEER et TokenClimate).
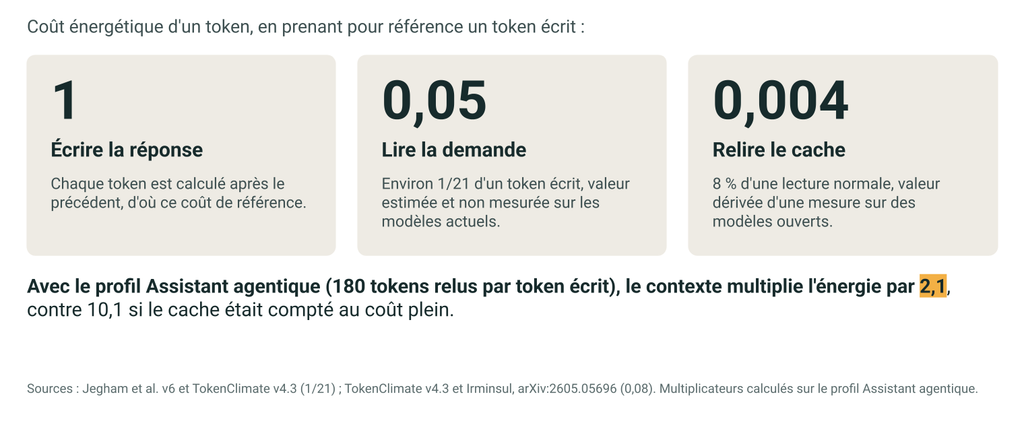
Reste une inconnue de taille : à chaque mot produit, le modèle relit tout le contexte en mémoire. Les mesures publiées s’arrêtent à 1 800 tokens de contexte ; personne, à notre connaissance, n’a mesuré l’effet à 164 000. Pour nos usages intensifs, notre calcul sous-estime donc peut-être l’énergie d’un facteur 2 à 10.
Ce que les éditeurs ne publient pas
Quatre données manquent, que seul l’éditeur détient.
- La taille du modèle. Aucun grand éditeur ne publie le nombre de paramètres de ses modèles fermés. EcoLogits estime Opus 5 à 670 milliards de paramètres, dont 67 à 200 milliards actifs par token. Notre fourchette traduit donc ce qu’on ignore, pas un intervalle de confiance.
- Le coût d’un token lu ou relu depuis le cache, facturé mais jamais publié en énergie.
- Le matériel. Les facteurs d’EcoLogits supposent des GPU H100 ; nos modèles tournent en partie sur d’autres puces, peu documentées.
- La localisation. Pour la même énergie, un centre de données sur le réseau américain émet sept à huit fois plus qu’en France. Passer d’un mix américain au mix mondial de Green IT a fait varier notre résultat de 156 à environ 200 kgCO2e par an, sans qu’un seul token change.
Les chiffres des éditeurs ne sont pas comparables entre eux. Mistral publie 1,14 gCO2e et 45 mL d’eau pour une réponse de 400 tokens, mais pas l’énergie.
Partir du parc mondial ou partir de nos tokens
Une autre approche s’est imposée en interne, par le haut. En septembre 2026, l’association Green IT a publié la deuxième version de son étude sur les impacts de l’IA dans le monde : 174 TWh d’électricité et 99 millions de tonnes de CO2e par an, fabrication comprise, sur seize indicateurs environnementaux.
Mais le ramener à notre usage supposait de connaître le nombre d’utilisateurs par serveur, que personne ne publie.
Nous avons relié les deux approches par le kilowattheure. L’étude donne un impact par kWh consommé par un serveur d’IA : 0,52 kgCO2e pour le mix électrique seul, 0,57 avec la fabrication. Appliqué à nos kWh estimés, cela donne nos 200 kg, sans nombre d’utilisateurs inventé. Cette clé suppose aussi que les impacts sont proportionnels à l’énergie, ce qui est faux pour les indicateurs dominés par la fabrication (ressources minérales, eau). Limite : cette clé ne nous attribue aucune part de l’entraînement des modèles.
Ce qu’on propose, en attendant mieux
Plutôt que d’attendre une norme (l’AFNOR SPEC 2314 sur l’IA frugale existe, l’UIT travaille sur un cadre de mesure), nous travaillons avec ce qu’on a. Notre méthode tient en cinq principes :
- Compter en tokens, en quatre classes : générés, lus, écrits et lus en cache. Ce sont les seules données mesurées : exigez-les de votre éditeur.
- Donner à chaque modèle un facteur d’énergie pour 1 000 tokens générés, en valeur basse, centrale et haute.
- Garder les hypothèses visibles et modifiables : chacune avec sa plage et sa source.
- Annoncer un ordre de grandeur, toujours avec sa fourchette.
- Suivre la variation plutôt que le niveau. À hypothèses constantes, elle dit si une action a marché.
Ce cadre ne couvre que l’usage : c’est un plancher : ce qui n’est pas compté ne peut que s’y ajouter.
Les leviers, dans l’ordre
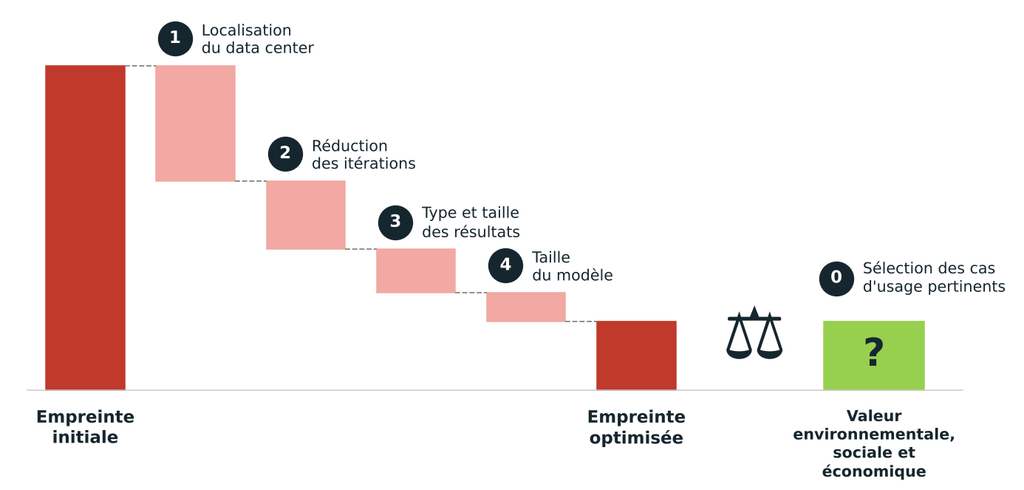
Nous posons trois questions, dans cet ordre : le projet doit-il exister ? Une solution sans IA suffit-elle ? Et seulement ensuite : comment le faire avec le minimum de ressources ? La mesure ne répond qu’à la troisième. Nous les avons rassemblées dans une checklist de vingt points de contrôle.
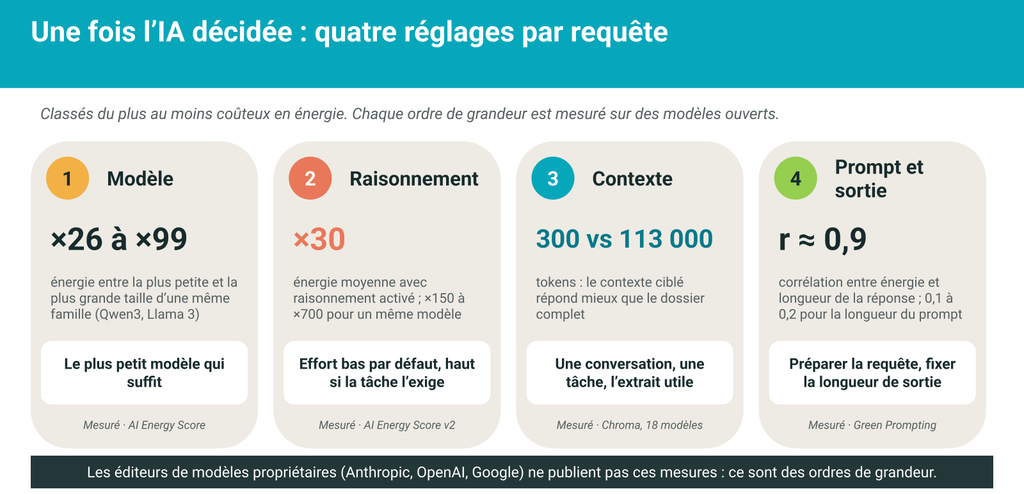
Au quotidien, les leviers de frugalité recoupent notre export : choisir le plus petit modèle qui suffit, tout dire dès la première consigne, fermer une session plutôt que la laisser accumuler 164 000 tokens, et choisir la région de traitement quand l’offre le permet. Attention à l’effet rebond : les gains d’efficacité sont vite absorbés par la hausse des volumes. Notre lecture est que seule la question de la sobriété casse cette boucle.
Ce que nous aimerions demander aux éditeurs
Quatre données suffiraient à lever la plus grosse part de l’incertitude : l’énergie mesurée pour 1 000 tokens générés et lus, par modèle ; le coût réel d’un token relu depuis le cache ; la localisation du traitement ou l’intensité carbone de son mix ; une part d’entraînement amortie par token. Google et Mistral en publient déjà une partie : il manque une convention commune. Selon nous, la transparence viendra des acheteurs, le jour où ils poseront ces questions dans leurs appels d’offres.
Mesurer quand même
Un chiffre à un facteur 12 près ressemble à un échec. C’est peut-être juste l’état de la connaissance, et les chiffres plus précis qui circulent cachent souvent mieux leurs hypothèses. Il faut mesurer quand même, en tokens, avec des hypothèses visibles, et suivre la variation d’une année sur l’autre plutôt que le niveau. Le simple classement de notre export a d’ailleurs suffi à décider où agir.
L’incertitude sert aujourd’hui aux uns à dire que l’IA ne pèse rien, aux autres à ne rien publier. Nous préférons afficher un chiffre avec sa plage, ses hypothèses et ses trous, pour que chacun puisse le contester.
Et vous, comment mesurez-vous l’impact de vos usages d’IA ?
Sources
- EcoLogits, méthodologie d’inférence LLM, modèles propriétaires et dépôt mlco2/ecologits.
- Green IT, « Impacts environnementaux de l’intelligence artificielle dans le monde », v2.0, septembre 2026.
- Google, mesure d’une requête Gemini, août 2025, reprise par MIT Technology Review.
- Mistral AI, « Our contribution to a global environmental standard for AI », juillet 2025.
- CLEER (Sustainable AI Group) et TokenClimate, méthodes de calcul par token, septembre 2026.
- Mesures du coût relatif de la lecture : Caravaca et al. (2025) ; Vellaisamy et al. (2026) ; Chkir et al. (2026).
- AFNOR SPEC 2314 (IA frugale) ; UIT-T L.1801 (cadre de mesure en cours).
- AI Energy Score, Hugging Face et Salesforce : lancement, février 2025 et version 2, décembre 2025.
- Hong, Troynikov et Huber, « Context Rot: How Increasing Input Tokens Impacts LLM Performance », Chroma, juillet 2025.
- Adamska et al., « Green Prompting », arXiv, mars 2025
- Nuageo, Checklist IA – mise à jour octobre 2026.